


L’intelligence artificielle locale change la façon dont on exploite un ordinateur en plaçant la confidentialité et la maîtrise des ressources au centre des choix techniques. Elle demande cependant des ajustements matériels et logiciels pour éviter les blocages et garantir une performance constante. Dans ce guide, je détaille des méthodes pratiques pour préparer un poste ou un serveur à l’IA locale tout en limitant les coûts et l’impact environnemental. Vous trouverez des recommandations sur le GPU, la gestion de la mémoire, le dimensionnement des modèles et l’intérêt d’un serveur dédié.
Quel GPU privilégier pour l’IA locale ?
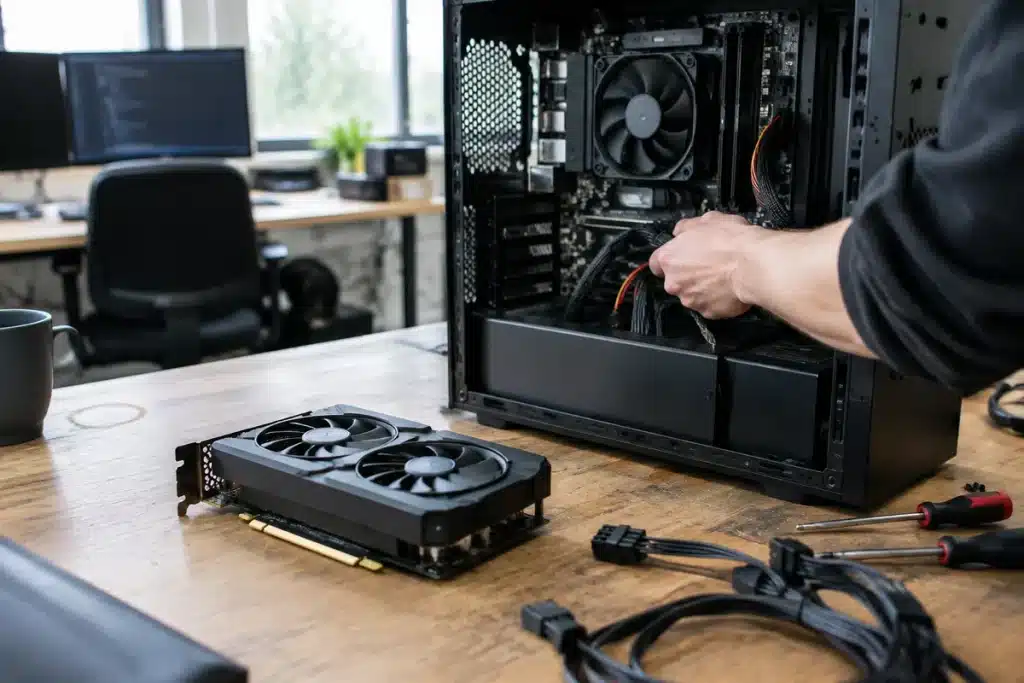
Le choix du processeur graphique influence fortement les temps d’inférence et la stabilité. Les cartes Nvidia restent souvent en tête grâce aux cœurs CUDA et à un écosystème logiciel bien développé. En pratique, l’usage d’un GPU Nvidia accélère nettement l’exécution des modèles et réduit les erreurs liées aux ressources.
Les pilotes propriétaires sont cruciaux, surtout sous Linux, pour garantir que le GPU soit correctement détecté et exploité. Fedora et d’autres distributions reconnaissent rapidement une carte Nvidia une fois les drivers installés et configurés. L’intégration de CUDA dans votre environnement d’inférence diminue significativement la latence et augmente le débit des calculs. Cette mise au point améliore l’expérience utilisateur et la fiabilité des tâches lourdes.
Les GPU AMD offrent une alternative intéressante si vous installez ROCm, la pile logicielle d’AMD pour l’IA. Mon expérience montre que ROCm peut rendre les machines AMD performantes pour des modèles exigeants. Pour un déploiement rapide et une compatibilité maximale, Nvidia reste toutefois le choix recommandé.
Comment réduire les blocages mémoire sous Linux ?
La compression de la mémoire vive aide à atténuer les débordements qui provoquent des plantages. ZRAM crée un périphérique en RAM qui stocke des données compressées et augmente la mémoire utilisable. Selon la charge de travail, on peut tenir entre 1,5 et 3 fois plus d’informations dans la même RAM, ce qui limite le recours au swap disque et conserve la réactivité.
ZRAM ne remplacera pas une quantité de RAM suffisante pour exécuter les plus grands modèles, mais il suffit souvent pour stabiliser le système avec des modèles petits à moyens. Les distributions non-Linux ne bénéficient pas directement de cette approche. Vérifiez la configuration et surveillez l’utilisation mémoire en charge pour ajuster les paramètres.
Quel modèle choisir pour chaque tâche ?
Le bon modèle dépend autant de l’usage que des ressources disponibles sur la machine. Pour des tâches légères comme rédiger des brouillons, résumer des textes ou répondre à des emails, un modèle peu volumineux est souvent suffisant. Les opérations analytiques plus complexes demandent des modèles de taille moyenne ou supérieure.
Les noms de modèles fournissent souvent un indice sur leur taille et leurs besoins en ressources. Voici une règle générale pour vous repérer.
- Petits modèles — fréquemment 1B, 2B, 7B ou 8B.
- Modèles moyens — autour de 30B à 70B.
- Grands modèles — plusieurs centaines de milliards ou plus, appelés LLM ou modèles de pointe.
Lorsque le nom du modèle n’indique pas la taille, consultez le fichier config.json pour repérer des paramètres comme num_hidden_layers ou hidden_size. En local, préférez d’abord des modèles petits, puis montez en gamme selon les observations terrain. En testant plusieurs variantes, vous identifierez le meilleur équilibre entre latence, coût mémoire et précision.
Faut-il installer l’IA sur un serveur dédié ?
La séparation des charges évite que l’IA ne monopolise votre machine principale et provoque des ralentissements. Un serveur dédié sur le réseau local permet de concentrer CPU, GPU et RAM pour l’inférence sans sacrifier la productivité quotidienne. Cette approche augmente la robustesse et la disponibilité des services IA.
Les serveurs sans environnement graphique offrent davantage de ressources disponibles pour l’inférence et les processus backend. J’expose souvent l’outil d’inférence sur le LAN et je redirige les requêtes de mes postes vers ce serveur. Cette configuration reste transparente pour l’utilisateur final et facilite les mises à jour et la maintenance centralisée.
Voici un tableau récapitulatif pour comparer les options matérielles et leurs limites.
| Composant | Avantages | Limites |
|---|---|---|
| GPU Nvidia | Très performant pour l’inférence, large support logiciel, CUDA bien établi | Coût élevé sur les modèles haut de gamme |
| GPU AMD | Bon rapport prix/performance, ROCm évolutif | Support logiciel moins homogène selon les distributions |
| ZRAM | Améliore la réactivité sous débordement mémoire, simple à activer sous Linux | Ne remplace pas une RAM insuffisante pour les très grands modèles |
| Serveur dédié | Isolation des ressources, scalabilité, administration centralisée | Travail d’installation et coûts initiaux |
Ce tableau vous aidera à comparer rapidement coût, performance et facilité de déploiement. Les choix finaux dépendront de votre budget, de la charge prévue et des compétences en administration système. Pour des besoins croissants, la montée en puissance via un serveur dédié ou une machine plus puissante reste la stratégie la plus simple.